지난 7년 동안 ChatGPT, Claude, Gemini 등 우리가 접해온 모든 메이저 대형언어모델(LLM)은 예외 없이 트랜스포머(Transformer) 아키텍처라는 단 하나의 거대한 기둥 위에서 작동해 왔습니다.
하지만 트랜스포머에는 치명적이고 막대한 비용을 발생시키는 약점이 존재합니다. 모델의 성능을 올리기 위해서는 무차별적인 고용량 데이터와 천문학적인 컴퓨팅 파워가 필요하며, 문맥(Context)이 길어질수록 연산 비용이 급격하게 증가한다는 점입니다.
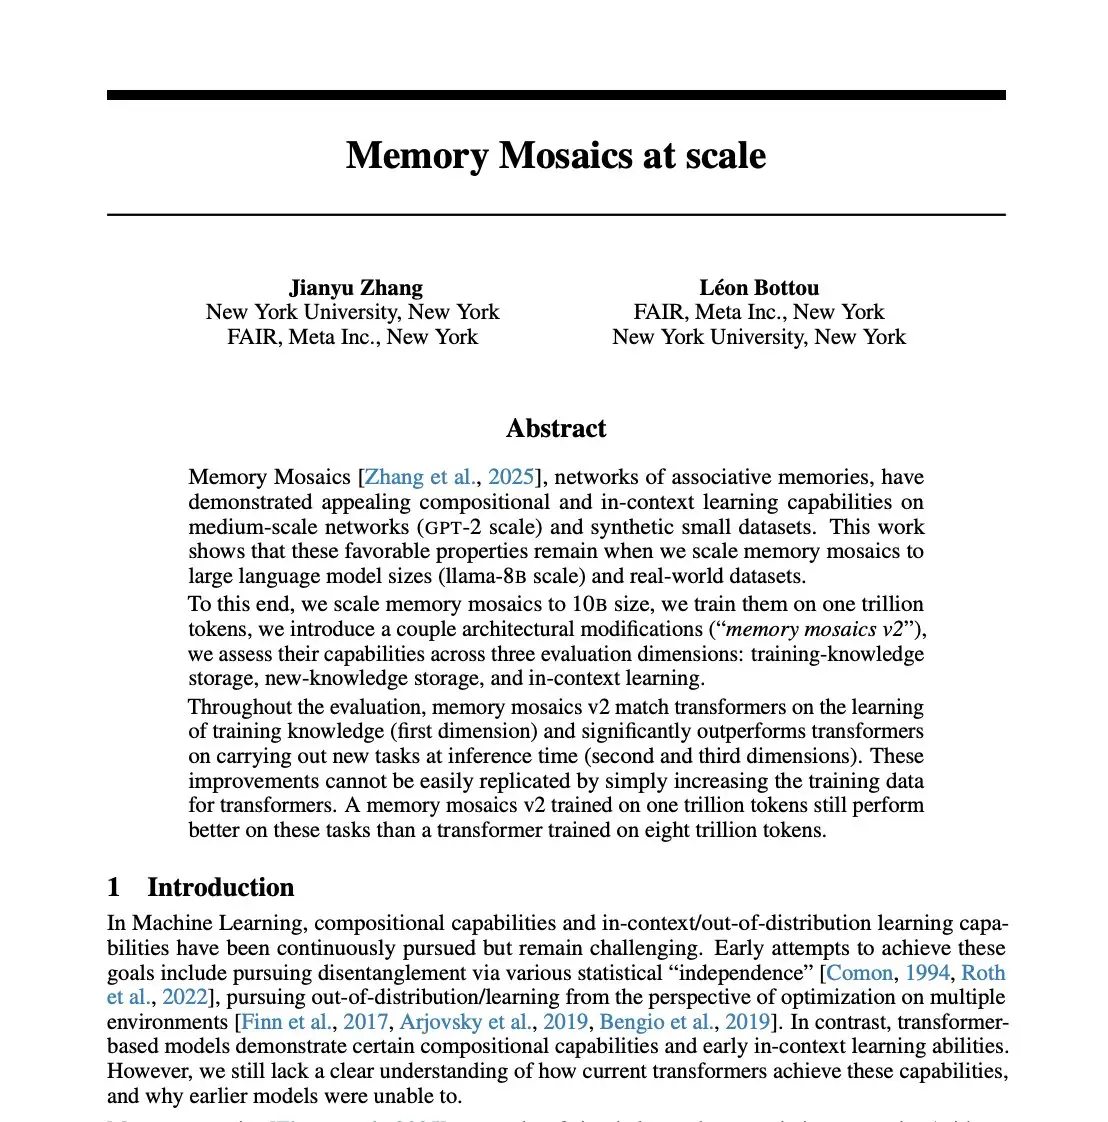
최근 Meta Research에서 발표한 논문 “Memory Mosaics at scale”은 이러한 트랜스포머 아키텍처 중심의 AI 연산 방식에 근본적인 질문을 던지며 큰 주목을 받고 있습니다.
기존 트랜스포머 아키텍처의 한계와 연산 병목
트랜스포머의 핵심 기전인 어텐션 메커니즘(Attention Mechanism)은 입력된 데이터의 모든 토큰 간의 관계를 계산합니다.
- 2차 연산 비용 (O(N²)): 입출력 문맥이 길어질수록 메모리와 연산량이 제곱으로 증가합니다.
- 무차별적 데이터 상향(Brute-force Scaling): 모델을 스마트하게 만들기 위해 수조 단위의 토큰과 대규모 GPU 데이터 센터를 가동해야 합니다.
이로 인해 AI 업계에서는 “더 큰 GPU, 더 많은 엔비디아 칩”만이 유일한 해결책인 것처럼 인식되어 왔습니다.
메모리 모자이크(Memory Mosaics)란 무엇인가?
Meta 연구진(Zhang et al., 2025/2026)이 제시한 메모리 모자이크(Memory Mosaics)의 핵심 개념은 연상 메모리(Associative Memories) 네트워크입니다.
복잡한 시퀀스 방정식을 실시간 계산으로 계속 풀어내는 대신, Key-Value(키-값) 쌍을 효율적으로 저장하고 필요할 때 선택적으로 인덱싱하여 불러오는 방식을 취합니다.
핵심 성능 측정 결과
- 8배 뛰어난 데이터 효율성: 단 1조(1 Trillion) 토큰으로 학습된 메모리 모자이크 모델이 기존 8조(8 Trillion) 토큰으로 학습된 트랜스포머 모델의 성과를 능가했습니다.
- 복잡한 문제의 자동 분해: 복잡한 추론 문제를 스스로 작고 독립적인 하위 과제(Sub-tasks)로 자연스럽게 분리하여 처리합니다.
- 뛰어난 문맥 내 학습(In-Context Learning): 소량의 예시만으로도 새로운 태스크를 신속하게 해결하는 능력을 보여줍니다.
메모리 모자이크가 강점을 보이는 실제 유스케이스
- 장문 문서 질의응답(Long-Document Q&A): 긴 문서나 비공개 개별 데이터를 즉석에서 추출·조합하여 답을 도출하는 데 탁월합니다.
- 임시 분류 체계 학습: 사전 학습되지 않은 새로운 범주나 규칙이 주어졌을 때 예시 몇 개만으로 신속하게 분류 모델을 형성합니다.
- 유사 개념의 명확한 분리: 유사해 보이는 정보 간의 미세한 차이를 분해하여 혼동 없이 고성능으로 검색 및 추론합니다.
냉정한 기술적 평가: 과연 트랜스포머를 완전 대체할 것인가?
이 기술에 대해 AI 학계 및 산업계에서는 열광적인 반응과 함께 신중하고 입체적인 시각도 공존하고 있습니다.
① 트랜스포머의 ‘완전한 대체’인가, ‘하이브리드 조합’인가?
과거 Mamba, RWKV 같은 상태 공간 모델(SSM)이 등장했을 때도 트랜스포머의 종말이 언급되었으나, 실제 산업 현장에서는 트랜스포머 레이어와 새로운 구조를 혼합한 하이브리드(Hybrid) 구조로 진화했습니다. 메모리 모자이크 역시 트랜스포머를 완전히 축출하기보다는 상호 보완적인 레이어로 융합될 가능성이 높다는 견해가 지배적입니다.
② 여전히 남아있는 2차 연산 비용 문제
일부 전문가들은 메모리 모자이크가 특정 벤치마크 평가에서 뛰어난 효율을 보였으나, 장기 메모리 및 Key-Value 관리 측면에서 2차 연산 메모리 한계를 완전히 해소한 것은 아니라는 점을 지적합니다.
③ 벤치마크 평가 방식의 적절성
현재 사용되는 AI 평가 벤치마크 방식 자체가 트랜스포머 체계에 맞춰져 있어, 새로운 아키텍처의 실질적인 유용성을 검증하기 위한 정교한 튜링 테스트형 평가 체계가 수반되어야 한다는 논의도 활발합니다.
결론: 컴퓨팅 파워 중심에서 ‘아키텍처 효율성’으로의 전환
Meta의 ‘Memory Mosaics at scale’ 연구가 가지는 진정한 가치는 단순히 벤치마크 스코어를 올린 것에 그치지 않습니다.
거대 자본을 동원한 데이터 센터 확장 경쟁 속에서 “원시적인 컴퓨팅 파워 투입” 중심이었던 AI 발전 패러다임을 “아키텍처 자체의 구조적 효율성”으로 전환할 수 있는 계기를 마련했다는 점입니다.
소형화된 데이터와 저전력 컴퓨팅으로도 고성능 AI를 구현하는 지속 가능한 인공지능 시대로의 진화가 기대되는 시점입니다.
댓글 남기기